01ARXIV 2605.29979 · 2026 · 原文 v1
Fingerprinting Inference Systems of Large Language Models
从文本回答,辨认模型背后的推理系统
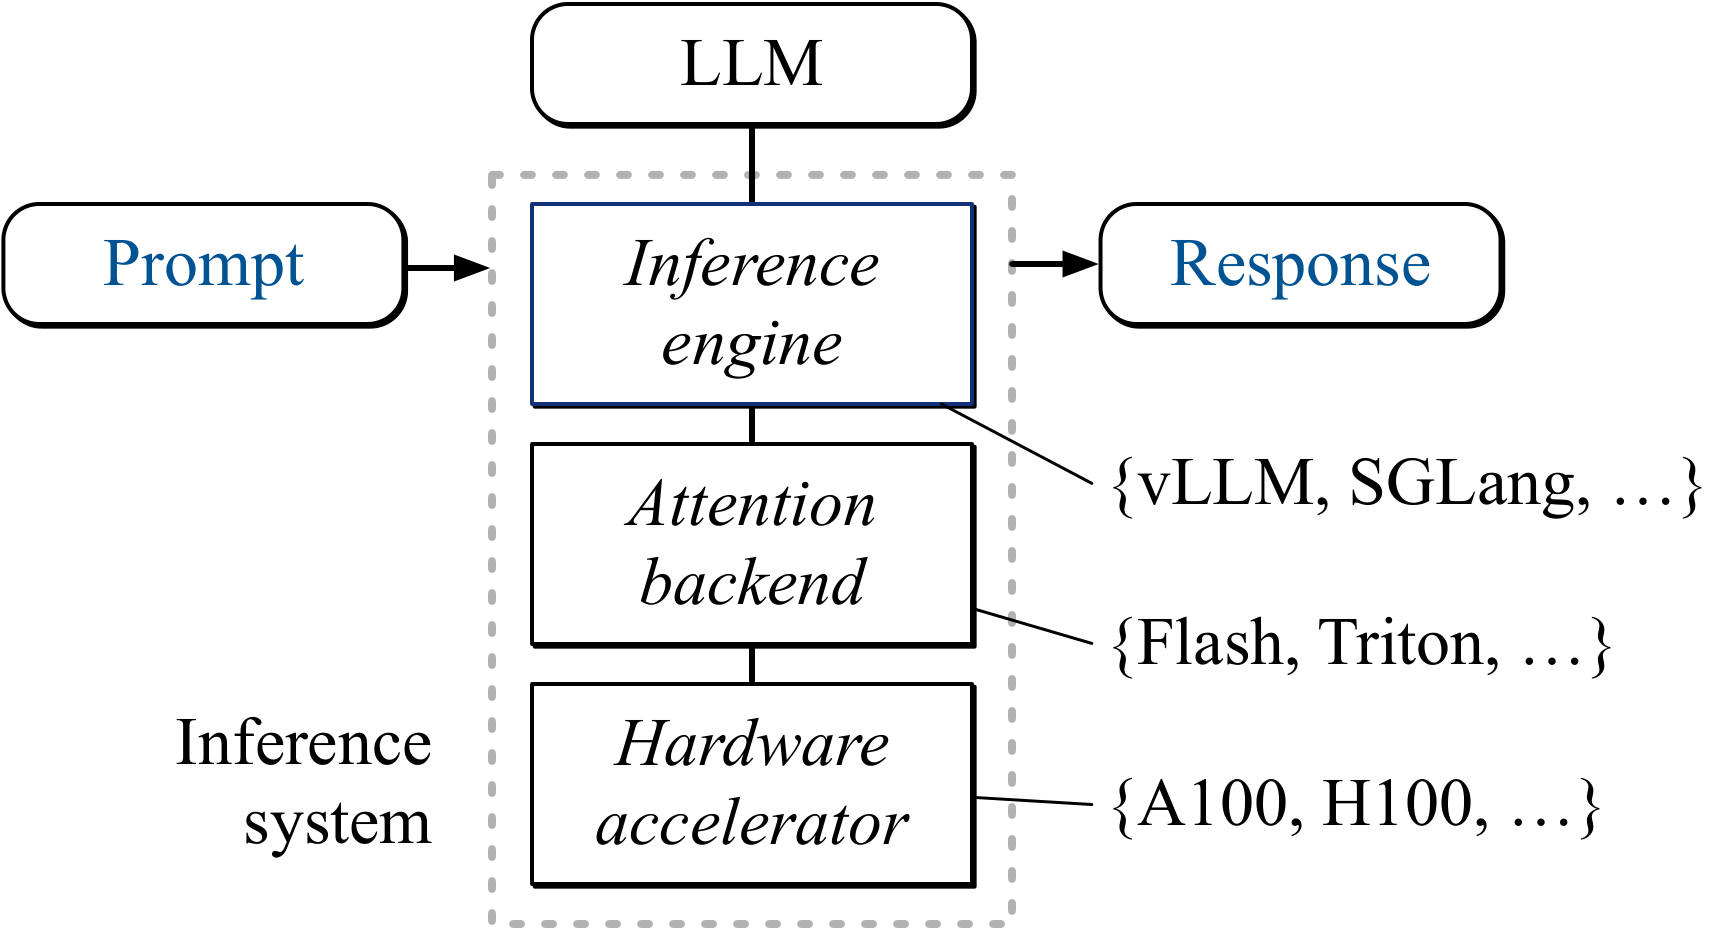
同一个模型的回答会留下推理引擎、注意力后端与 GPU 的数值指纹。论文在已知参考配置中验证了识别能力;随机解码、配置迁移与未知系统仍有明确边界。
14 页原文 · 5 幅原图 · 完整章节开始精读
A READING LIBRARY · 中文精读
把问题带进论文,把结论带回证据。
在同一个地方阅读、检索和比较,沿原文章节继续深读。
支持中英文与 arXiv 编号,例如 GPU、量化、威胁模型、temperature
共 2 篇论文,按发表时间排列
从文本回答,辨认模型背后的推理系统
同一个模型的回答会留下推理引擎、注意力后端与 GPU 的数值指纹。论文在已知参考配置中验证了识别能力;随机解码、配置迁移与未知系统仍有明确边界。
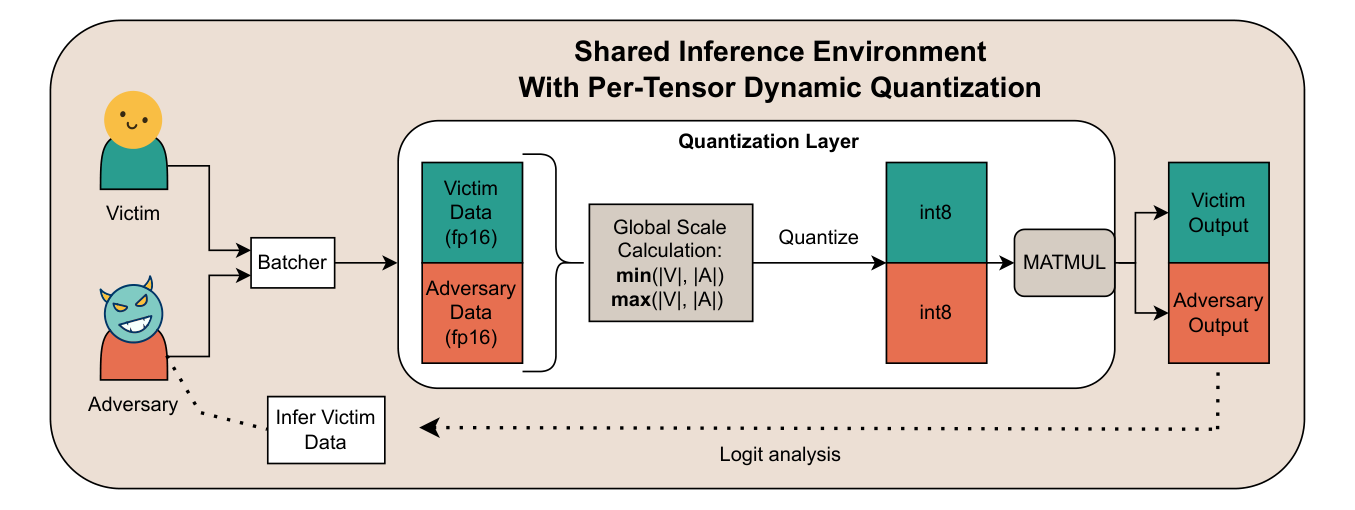
当量化尺度越过用户边界,合批也会泄露数据
跨样本共享的动态量化尺度,可能让自身输出携带同批数据的信息。受控实验展示了候选匹配与 token 恢复;未知类别推断和真实部署噪声揭示了利用限制。
试试更短的关键词,或搜索论文编号、英文标题和章节名称。
RELATED GUIDES
以下为独立旧站,保留外部入口;未计入本次两篇论文的迁移与搜索。