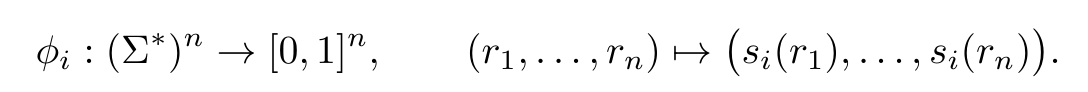
稀有 token · Rare token prompts
把不常见的 Unicode 标识符藏进无关文本,再要求模型找回。期望放大自回归生成中细小偏差对低概率 token 选择的影响。不是比谁“知道更多知识”,而是观察是否还原相同标识。
原始候选池:1,700 条 · 评分:是否包含目标 token同一个语言模型的文本回答,会泄露推理软件和 GPU 留下的数值“指纹”;但可靠识别依赖已知模型、已知系统提示词和可复现的候选系统。
论文把浮点计算的细小差异从“复现性问题”改写为“基础设施信息泄露问题”:不用 logits,只通过四类精心设计的提示词,把回答压缩为命中、是/否、重复次数等特征,再用三个随机森林分别识别推理引擎、注意力后端和 GPU。作者在 30 种开源系统组合、3 个模型上发现:温度为零且配置已在参考集合中时,可用每模型 68–113 个提示词实现全部组件 100% 识别;加入采样后,重复查询仍保留信号,但效果明显依赖模型和组件。研究证明了文本层面侧信道的存在;它没有证明能直接识别任意商业 API 的秘密基础设施,也没有给出彻底消除泄露而不损失效用的防御。
↗ 摘要 · pp. 1–2↗ 核心结果 · pp. 6–8下文按原文章节、子章节与段落标题展开,用中文解释论证而非逐句翻译。原图来自同一版本 PDF/TeX;“阅读评议”与“本页推算”均单独标注。
为什么相同权重、相同输入,却能得到不同答案?实际推理不是抽象的矩阵公式,而是由具体硬件、注意力内核、缓存和调度器完成的一串浮点运算。改变计算的顺序或实现,微小舍入误差就可能累积,最终让最可能的 token 换位。
论文的关键转向是:这些偏差可能带有系统组件的特征。对防御者,这是一个被忽略的信息泄露面;对购买算力的客户,它也可能成为核查服务声明的工具。识别引擎可以帮助攻击者缩小漏洞搜寻范围,但识别组件本身不等于入侵系统。
作者贡献的重点不在“GPU 会算出略有差别的数”这个旧事实,而在于把这种差别带到通常唯一可见的文本回答中,并实证区分引擎、后端与硬件。引言中的高准确率概括需要带着实验前提阅读,后文会拆开看。
底层 GPU 执行高吞吐运算;中间的 attention backend 负责注意力计算以及分块、内核融合和访存优化;上层 inference engine 负责请求批处理、KV cache、多设备并行与服务接口。模型权重相同,不代表这三层的数值路径相同。
原图说明:An LLM inference system.
从 Prompt 到 Response,中间经过引擎、注意力后端与硬件加速器。图中候选组件是例示,并不意味着任意组合都可运行。
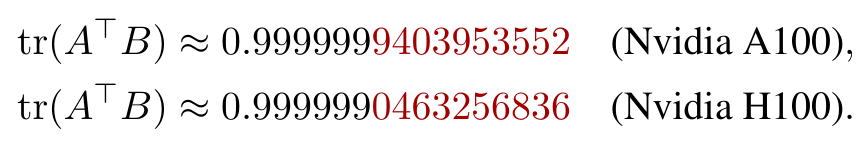
浮点加法没有严格的结合律。换一种归约顺序、张量布局或内核调度,数学等价的运算就可能产生不同末位。论文举了一个单精度例子:,,,数学上的结果是 。
保留原文符号与精度;原文为无编号公式,不补造公式编号。↗ 原公式 · p. 3 查看原公式截图
单次偏差看起来很小,但一次前向传播包含大量运算;若两个候选 token 的分数足够接近,差异会跨过决策边界。Table 1 的同一 Qwen2.5-7B 模型,在不同系统上对 1966 年世界杯问题给出不同的 Yes/No 倾向:前两组输出 No,TensorRT-LLM 那组输出 Yes。这不是模型权重变了。
SGLang / FlashAttention / A100:Yes 0.3775,No 0.6224;SGLang / FlashInfer / H100:两项均显示为 0.4999;TensorRT-LLM / FlashInfer / H100:Yes 0.5622,No 0.4378。
↗ 原表 · p. 3整个方法分两步:先在候选参考系统上收集可区分的提示词—回答模式,再把目标的回答变成相同特征,交给分类器。三个组件分别预测,得到三个标签;这不是从任意一条回答里直接“读出显卡型号”。
不同输入会触发不同推理阶段,因此作者不用一套普通问答覆盖一切,而是设计四组提示词 。下面保留其原符号;“触发阶段”是作者的设计解释,不意味着已经用独立消融完全隔离了每种机制。
把不常见的 Unicode 标识符藏进无关文本,再要求模型找回。期望放大自回归生成中细小偏差对低概率 token 选择的影响。不是比谁“知道更多知识”,而是观察是否还原相同标识。
原始候选池:1,700 条 · 评分:是否包含目标 token问只能回答 Yes/No 的问题。对非推理模型,单 token 输出尽量减少后续生成,把观测重点放在 prefill。对推理模型,这个“只有一步生成”的解释需要更谨慎。
原始候选池:5,000 条 BoolQ 问题 · 评分:是否以 yes 开头在长文本中埋入普通数字标识,例如 NUM=745,再要求返回数字。作者希望通过触发 chunked prefill,让分块计算的差异可见;实际是否分块,也会依赖引擎设置与阈值。
原始候选池:150 条 · 评分:是否包含目标数字要求重复一个句子或词 100 次,观察实际重复次数。作者将此与 KV-cache prefix reuse 的管理差异联系起来;把次数变为特征,不是比较整段文字的语义。
原始候选池:100 条 · 评分:相对要求次数归一化的重复数四组总计 6,950 条候选提示词,但这并不是最终每次指纹识别的查询预算。确定性实验会缩减提示词集合;随机解码还要考虑每条重复多少次。
↗ 候选池数量 · §4,p. 5这里的 embedding 不是大型语义向量模型。给定提示词集合 和回答 ,评分函数 只提取当前提示词组关心的属性:
原文为无编号公式。↗ 原公式 · §3.2,p. 4 查看原公式截图
与 用命中/未命中的 0、1 指示; 判断回答是否以 “yes” 开头; 把重复次数相对请求次数归一化到 。四个 拼成总特征向量,所以特征对提示词的固定排列有依赖。
在所有有效参考组合上采样,分别训练三个 random forest:一个预测 inference engine,一个预测 attention backend,一个预测 GPU type。论文实验有 30 个参考系统;并没有声称 4×6×3 的 72 种笛卡尔积组合都有效。
给目标发送相同提示词,用相同评分函数生成特征,再取分类结果。温度非零时,训练每个提示词采集 个 prompt–response pairs,识别时采集 个,靠多数投票缓解采样噪声。论文交代了这种高层协议,但没有给出完整采样配对、投票平局规则或随机森林超参数。
有三个要提前决定的量:候选组件范围、提示词总量 、每条查询重复数 。扩大后两者可能增加信号,也会增加调用、输入 token 和输出 token 的成本。作者选择可自由组合和复现的开源栈;OpenAI、Anthropic、Google 等专有部署不满足相同的参考系统可得性假设。
组件覆盖 4 个引擎、6 个后端与 3 种 GPU。兼容性限制使引擎—后端只有 10 对有效组合;再分别放到 H100、A100、L4 上,得到 30 个系统。模型为 Llama-3.2-3B-Instruct、Qwen2.5-7B-Instruct 与具有推理能力的 Qwen3-4B,均使用 BF16。
| 目标 | 候选 | 论文所列均匀随机基线 |
|---|---|---|
| 引擎 | vLLM / SGLang / TensorRT-LLM / LMDeploy | 25% |
| 后端 | FlashAttention / FlashInfer / Triton / TRT-LLM / PyTorch / TurboMind | 约 17% |
| GPU | H100 / A100 / L4 | 约 33% |
作者因跨引擎兼容性选择这三个中小规模模型,并推测更多计算可能累积更多差异。这是研究动机,不是“大模型一定更容易识别”的实验结论。各组件类别在 30 种配置中的频数不完全相等,均匀猜标签的基线也不等于多数类基线。
参考数据使用对应模型的默认系统提示词。作者知道 batch size 与 batch position 会影响输出,因此实验中把提示词固定在同一批位置;批大小变化另在第 5 节测试。对真实动态服务,这种固定批位置是需要保留在脑中的控制条件。
当 且配置来自同一参考集合时,三个模型的引擎、后端、GPU 识别准确率全部达到 100%。作者明确指出,这时问题近似变成检索:只需把目标回答模式匹配回参考配置。因此 100% 是一个重要的“信号存在”结果,但不等于对未知部署也能达到相同准确率。
原图说明:Reduction of prompts for deterministic decoding.
最终集合分别为 Llama 68 条、Qwen2.5 107 条、Qwen3 113 条。组成随模型变化;113 是这三个缩减集合中的最大值,并非所有模型的统一最小量。
Llama 主要依赖二元问题;Qwen2.5 保留更多稀有 token 和重复提示;Qwen3 保留的长上下文提示更多。作者把后者与推理能力联系起来,但没有给出因果消融来单独验证这个解释。提示词子集选择的完整算法、是否独立于最终测试集,正文没有详细说明。
原图说明:Fingerprinting accuracy as a function of the number of prompts for deterministic decoding
横轴是对数刻度的提示词数,纵轴为准确率。引擎识别通常最早变得可靠,约 10 条已出现明显信号;后端与 GPU 往往需要接近 100 条。请以曲线与具体模型为准,不把“约 10 条”读成通用的 100% 保证。
作者在 上重复实验,训练用 ,目标识别用 ,训练与测试响应实例不重叠,运行 20 次并报告均值。这里留出的是响应实例;不是把所有模型或系统配置都换成从没见过的新类别。
| 模型 | 引擎 | 后端 | GPU |
|---|---|---|---|
| Llama-3.2 | 100 | 100 | 100 |
| Qwen2.5-7B | 100 | 100 | 100 |
| Qwen3-4B | 100 | 100 | 100 |
| 原文均值 | 100 | 100 | 100 |
T=0:全部 100%,前提是已知参考配置与匹配的受控条件。
↗ 数据来源 · Table 3,p. 7高层叙述最容易误读的地方在这里:76–80% 是引擎在三个非零温度上的跨模型均值,后端均值是 71% → 58% → 46%,GPU 是 78% → 59% → 58%。Qwen2.5 的表现较强,Llama 随温度升高降幅更明显;Qwen3 的引擎准确率在 T=0.9 反而回升到 85%,所以效果并非严格单调。
原图说明:Fingerprinting accuracy as a function of the number of aggregated samples k under stochastic decoding, averaged over all components.
每个模型画出三个温度下的曲线,纵轴已对三个目标组件取平均。重复采样有帮助,作者观察到约 10–20 个样本后收益趋于饱和;这不表示任意组件在 k=10 都已可靠。
若每条提示词重复 k 次,目标侧 prompt–response 采样数为 |P| × k。下方计算查询样本数;若 API 批量请求,它不等于 HTTP 请求数。也不估算价格、token、时延,或准备参考系统的成本。
论文随机解码协议采用 k=50:三个模型分别对应 3,400、5,350、5,650 个目标侧响应样本。l=768 则属于每条提示词、每个参考系统的训练响应数,不能把它当成测试调用数。
↗ l / k 的定义 · §3.2↗ 实验参数 · §4.2这部分并非所有“真实部署因素”的综合测试,而是分别隔离四项因素。除了温度迁移,其余实验都在 下进行,不能直接外推到动态批处理、未知提示词、未知温度与专有系统同时存在的情况。
作者从 fka/prompts.chat 取写作导师、旅行向导、私人教练三种角色提示,替换默认 system prompt。报告跨目标系统约 99.7% 准确率。但此实验仍建立在攻击者可以先提取并知道该系统提示词的假设上;它不是“训练用一个未知角色、测试随意换另一个角色”仍保持 99.7% 的证明。论文没有在正文完整展开每一角色/模型/组件的分项结果。
训练批大小为 ,测试只用 。这是确实留出的部署参数值:Qwen2.5 的引擎/后端/GPU 为 94/97/97%,Llama 为 90/84/85%,Qwen3 为 99/77/68%。因此“影响小”需要分组件看:Qwen3 的 GPU 从匹配条件的 100% 降到 68%,不能忽略。
作者模拟攻击者无法访问某个组件实现:训练时完全排除包含该实现的配置,测试只用包含它的配置。例如训练不用 A100,测试只看 A100 系统。然后观察其他仍属于已知候选集合的组件还能否被识别。
原图说明:Fingerprinting accuracy (%) at deterministic decoding where the proprietary system component is not used during training.
横轴表示留出的组件类别,纵轴表示被预测的类别。对角线是破折号:没有报告识别那个未知组件本身的能力。留出 GPU 时,引擎准确率为 Llama 53%、Qwen2.5 81%、Qwen3 95%;留出引擎时,后端只有 19%、29%、16%,后一项甚至接近/低于论文的 17% 均匀随机基线。
在 之间跨温度迁移,三模型平均引擎准确率降到 38–49%,后端为 30–38%,GPU 为 34–42%。这不是“略有下降”,而是显著削弱了匹配温度时的优势。作者建议攻击者对齐训练温度,并讨论通过重复查询推测温度,但没有验证一个完整、可靠的温度估计流程。
按三模型取均值。列依次为 0.3→0.6、0.3→0.9、0.6→0.3、0.6→0.9、0.9→0.3、0.9→0.6;引擎 48、44、39、44、38、49,后端 37、30、37、33、38、36,GPU 41、40、34、38、34、42。
↗ 原表 · p. 8一条研究线讨论推理框架、LLM、BLAS 与 FlashAttention 的数值偏差和非确定性。本文把这些“为什么不完全一致”的发现转换成“能否据此区分执行系统”的安全问题。最接近的硬件/软件平台推断工作依赖 log-probabilities;本文的实质进展是把访问条件降到文本回答。
另一条研究线通过接口输出推断投影层、追踪服务的静默更新、识别模型身份或验证语义水印。它们和本文的关系是互补:模型指纹识别回答“哪个模型”,本文先假定模型已知,再问“谁在怎样执行它”。不能把这两种指纹能力混为一谈。
如果让所有系统执行完全统一的数值路径,可以从根上压低差异;作者认为这种统一在生产中会牺牲硬件、时延与模型规模上的选择空间。另一条路是加入足够噪声,让原本稳定的回答发生变化,但这会影响确定性与任务效用。论文讨论了对参数或输入加噪,没有提供一条经过实测的“隐私—效用”最佳曲线。
对高风险或要求稳定输出的应用,靠扰动答案来隐匿指纹尤其需要谨慎。限制提示词长度与查询数量是作者认为较容易落地的部分缓解,不过仍可能受到多账户分摊查询的挑战。这里是防御讨论,不是已证明的完全阻断方案。
论文最值得保留的结论是:LLM 的可观测行为不仅由权重决定,也与执行它的软件和硬件有关。即使 API 不暴露分数,文本本身也可能包含能被学习的系统信息。
对系统安全,这意味着“不公开部署细节”不能单独成为防线;对可复现性,它提示我们需要记录模型之外的执行环境。至于能否据此可靠识别一个陌生线上服务,仍要逐项检查先验、参考系统可得性、温度、批处理和查询预算。
论文披露资助来自 European Research Council 的 MALFOY 项目(101043410),以及德国 DFG Excellence Strategy 的 CASA 项目(EXC 2092 CASA - 390781972)。此项是原文结构的一部分,不构成效果独立复现或部署验证。
参考文献位于 PDF 第 10–11 页。保留原始书目,避免把未逐篇核验的引文转述成独立证据。本阅读站的实证判断均依据当前这篇论文及其附录。
组件指纹识别具有双重用途:帮助审计部署、发现可复现性问题,也可能被用来为攻击筛选目标。作者通过公开这一侧信道及对应缓解思路,希望推动更可信的 LLM 基础设施。这里提出的是风险与研究价值,不是“只要知道显卡就能攻破服务”的主张。
附录把实验中“到底运行了什么”列得更具体。以下版本按论文原表逐字保留,尤其 SGLang 的 “v.5.5” 和 lmdeploy 的 “12.0”;不擅自补成看起来更常见的版本号。若要复现,应向作者或实际工件核对这些字符串。
| 引擎 | 原文版本字符串 | 许可证 |
|---|---|---|
| vLLM | 0.15.0 | Apache-2.0 |
| SGLang | v.5.5 | Apache-2.0 |
| TensorRT-LLM | 1.3.0rc0 | Apache-2.0 |
| lmdeploy | 12.0 | Apache-2.0 |
Table 7 的 10 个有效引擎—后端组合是:vLLM 与 SGLang 各支持 FlashAttention、FlashInfer、Triton;TensorRT-LLM 使用 FlashInfer 或 TRTLLM;LMDeploy 使用 PyTorch 或 TurboMind。每一对再配三种 GPU,形成 30 组实验条件。这种兼容性结构也意味着后端与引擎标签存在相关性。
Table 8:H100 对应 Hopper/GH100,A100 对应 Ampere/GA100,L4 对应 Ada Lovelace/AD104。本文在这些 NVIDIA GPU 上验证,未覆盖 AMD GPU、CPU 或其他加速器。
| 对象 | 精确标识符 | Revision |
|---|---|---|
| Llama | meta-llama/Llama-3.2-3B-Instruct | 0cb88a4 |
| Qwen2.5 | Qwen/Qwen2.5-7B-Instruct | a09a354 |
| Qwen3 | Qwen/Qwen3-4B | 851bf6e |
| 角色提示词 | fka/prompts.chat | 1670446 |
| 二元问题 | google/boolq | 35b264d |
三个模型的 dtype 均为 BF16;Llama 使用 Llama 3.2 许可,两项 Qwen 使用 Apache-2.0。数据集许可分别为 CC0-1.0 与 CC BY-SA 3.0。本文不是跨量化、跨精度或跨模型版本迁移的测试。
三段提示词从 fka/prompts.chat 随机抽样,用于第 5 节的应用专用系统提示词实验:
这些普通角色提示展示了实验不只使用默认 system prompt;它们并未覆盖复杂多层指令、不断变化的上下文或未知的服务端安全包装。原始英文提示保留如下,便于核对而不把概述误当成逐字转录。
有说服力的是“文本侧信道确实存在”。还没有被充分证明的是“对未知真实服务也能普遍、便宜、可靠地识别完整技术栈”。
把先前依赖 log-probabilities 的平台推断,推进到更常见的仅文本接口;提示词不是泛泛地“多问几次”,而是围绕不同计算阶段设计,特征简单可解释。确定性结果很清楚地表明,模型之外的执行差异足以留下可学习模式。
它是已知模型、已知系统提示词、参考候选已覆盖、T=0 的闭集结果。作者自己将其描述为检索。随机解码使用独立响应样本,增加了可信度,但不构成未知模型、未知组件类别或跨版本的泛化验证。
10 个有效引擎—后端组合并不均衡:某些后端只出现在一个引擎里。分类器可能同时利用真正的数值差异及这种兼容性相关结构。图 5 是有用的压力测试,但仍不足以把每个提示词组与一个内部机制建立唯一因果对应。
真实端点可能有未知 batch position、动态 batching、不同量化精度、硬件混合路由、软件更新与服务端过滤。这些因素没有被一起测试。尤其温度迁移结果显示,训练与部署失配会显著削弱优势。
非零温度结果是 20 次运行均值,但 Table 3 没有同时给出标准差或置信区间;也没有详细报告分类器参数与提示词筛选协议。查询样本数要用 k×|P| 计算,长上下文与重复生成会使 token 成本差异很大。论文没有给出货币成本和端到端耗时,因此本页也不编造。
异构执行栈会持续带来数值差异,是合理机制判断;但“无法实践中消除信号”比现有实验更强。本文未比较完整防御实现,也未测量隐私—效用曲线。更准确的结论是:彻底对齐数值行为代价高,部分缓解仍值得系统性评估。
讲解性伪代码(根据论文整理,非原文代码)。依据原文 §3.1–3.3(pp. 3–5)及 §3.2 的无编号嵌入公式,仅解释高层流程,不是可复现实验实现。适用于受控、获授权的参考系统实验;省略了论文未充分说明的细节。
输入:已知模型、已知系统提示词、可搭建的候选系统
准备:构造四类提示词,固定评分函数与提示词顺序

对每个参考系统:
    按论文设定重复采集每条提示词的响应
    用命中/yes 前缀/重复数映射成特征
分别训练三个随机森林:引擎、注意力后端、GPU

对待测系统:
    使用相同提示词与评分规则,采集 k 组响应
    构建对应特征并分别预测三个组件
    对随机解码的预测作多数投票

输出:候选标签中的预测值
注意:这一步没有自动得到“未知类别”的名字本页对应 arXiv:2605.29979v1,提交于 2026 年 5 月 28 日;2026 年 10 月 14 日读取 arXiv 时页面仅列 v1。标题、14 页 PDF 与 TeX 源码已逐项核对。页码指该 PDF 的印刷页码,恰与文件页序一致。
论文作者:Anna Wimbauer、Jonas Möller、Erik Imgrund、Konrad Rieck。原文标注 CC BY 4.0。本页对原文作中文概述与独立评议;原图、表格截图和公式来自原作品,图表仅作栅格化、裁切与尺寸适配,没有重画、改数或改色。TeX 源码仅安全解包与读取,未执行。
Figure 1 的原始资产为 PDF,Figure 2–5 的原始资产为 PGF。图 1 从原始矢量 PDF 完整栅格化,图 2–5 从原始论文 PDF 高分辨率裁取,点击可放大;原始图源保留供下载。公式依据原始 TeX 用本地 KaTeX 0.16.22 排版,所有依赖随站点保存,无 CDN 运行时请求。
验证范围:已核对原文结构、数学解析、数字与资源链接;执行环境限制了浏览器启动,尚未完成真实浏览器的跨设备视觉和交互验收。
PDF48c3a555591d2f98b61b0ed9c9d8d1c63fa15706bd3e2791b066224473578fe6
TeX 源码归档99716e8b6c03d384ca170ca6a55bcdc5e4110d05fdb7d70b68cb45c4e964a8cc